[Testy] Gdy ekspert spotyka LLM'a czyli czym jest paradygmat "hybrydowo neuro-symboliczny" i w jaki sposób uratuje on twój projekt przed ai slopem.
Prawda jest taka, że programiści są leniwi. A jeśli chodzi o testy, to każdy chce je mieć, mało kto chce je pisać. W obecnej erze AI często to zadanie, tak samo jak pisanie właściwego kodu, oddajemy w ręce agentów kodujących. Niestety agenci mają tendencję do powielania błędów w testach, które sami zaimplementowali w kodzie. Albo testują tylko proste i oczywiste przypadki.
Jednak AI to niejedyny sposób tworzenia testów. Już w latach 70-tych powstawały pierwsze koncepcje automatycznego wytwarzania testów. W roku 1976 badania Webba Millera dały świetne teoretyczne podwaliny pod generowanie testów. Po latach na bazie tych badań Mark Harman razem z Bryanem Jonesem ukuli w 2001 roku termin SBST - czyli Search-based software testing.
W tym artykule chcę pokazać, że połączenie SBST z testami generowanymi przez AI daje niesamowite rezultaty. To testy, które nie tylko pozwalają wykryć trudne do przewidzenia błędy, ale są także czytelne i łatwe w utrzymaniu. Spróbuję też pokazać, jak tę hybrydę zaimplementować w twoim workflow.
Czym jest SBST?
TL;DR SBST działa trochę jak naturalna selekcja. Generuje paczkę testów i sprawdza, które z nich sprawdzają najwięcej kodu. Słabe lub powtarzające się testy po prostu wyrzuca, a te najlepsze lekko modyfikuje i tworzy z nich nową, ulepszoną wersję. I powtarza ten cykl tak długo, aż wyciśnie z kodu maksymalną liczbę błędów.
Search-Based Software Testing działa na dość odważnym założeniu, że kod w obecnej formie działa prawidłowo. Nie analizuje też zupełnie sensu biznesowego kodu, który mamy do przetestowania. Działa to na zasadzie prostej pętli.
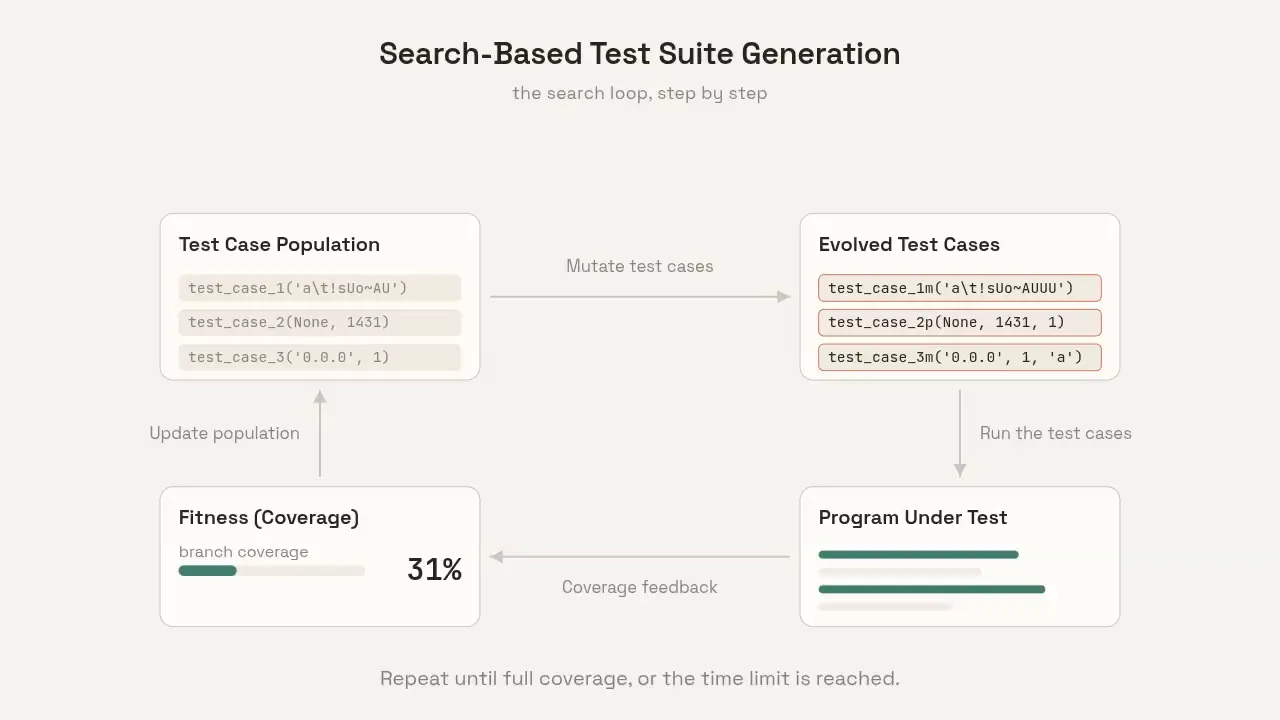
1️⃣ Inicjalizacja: Bierzemy istniejące przypadki testowe albo generujemy całkowicie losowe scenariusze startowe.
2️⃣ Mutacja i modyfikacja: Algorytm zmienia wyselekcjonowane testy na poziomie kodu i danych. Robi to na 3 sposoby:
- Mutacja danych (parametrów): podmienianie wartości na skrajne (np. 0, MAX_INT, null, nietypowe daty).
- Mutacja sekwencji kroków: zmiana konstrukcji testu (dodawanie, usuwanie lub zmiana kolejności kroków).
- Krzyżowanie (crossover): dzielenie dwóch testów i łączenie ich w jeden (np. dopracowany setup z pierwszego + asercje z drugiego).
3️⃣ Ocena(funkcja dopasowania): Uruchamiamy zmodyfikowane testy i przyznajemy im punkty. Algorytm sprawdza nie tylko to, czy test pokrył nową część kodu, ale też jak blisko był spełnienia trudnych warunków (np. wejścia do konkretnego if-a).
4️⃣ Selekcja i sukcesja: Na podstawie punktacji algorytm decyduje, które testy przetrwają. Aby wyłonić najlepsze i nie utknąć w ślepym zaułku, stosuje się kilka strategii:
- Elityzm: gwarancja, że absolutnie najlepszy test przechodzi do kolejnej iteracji bez zmian.
- Selekcja turniejowa: losowanie małej grupy testów i wybór najlepszego z nich (daje szansę słabszym i dba o różnorodność).
- Odrzucanie duplikatów: testy dające ten sam wynik są usuwane, aby algorytm nie utknął w generowaniu w kółko tego samego.
Problemy z SBST
Jak już pisałem powyżej, SBST działa przy założeniu, że kod który testujemy działa prawidłowo. Ta uwaga dotyka jednego z najważniejszych problemów w teorii testowania – problemu wyroczni testowej (test oracle problem).
Istnieje jeden wyjątek od tego założenia. SBST potrafi wykrywać błędy bez zakładania poprawności kodu, jeśli program ulegnie awarii krytycznej (np. rzuci nieobsługiwany wyjątek NullPointerException lub ulegnie przepełnieniu bufora). Dla algorytmu awaria (crash) jest uniwersalnym sygnałem błędu, niezależnie od logiki biznesowej.
Dlatego na poniższym wykresie, pokazującym skuteczność SBST, na przykładzie popularnego narzędzia EvoSuite, poziom wykrywania realnych błędów jest na dużym poziomie.
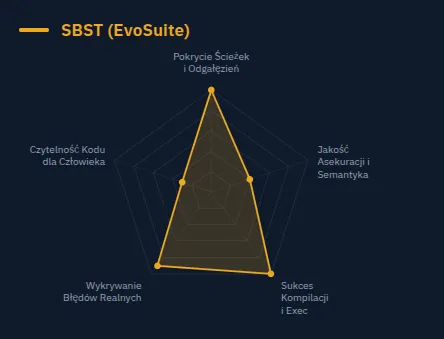
Wypada też nieźle jeśli chodzi o pokrycie ścieżek i odgałęzień. Ale to dość złudna metryka, bo rzeczywiście SBST dobrze znajduje możliwe scenariusze gdy w grę wchodzą proste liczby czy zmienne tekstowe. Ale gdy w teście pojawia się konieczność odgadnięcia dokładnego numeru PESEL bądź adres URL z końcówką .png algorytm może potrzebować bardzo wielu iteracji by odpowiednie wartości odnaleźć. Czasami liczba tych iteracji jest za wielka, by je wywoływać w rzeczywistych warunkach.
Do tego jak widzimy na wykresie, tak wygenerowany test jest dla człowieka mało czytelny. Jest to bezpośredni skutek słabej semantyki testu. Dla osoby czytającej ten kod, to chaotyczny zbiór testów i asercji gdzie za każdym razem trzeba próbować zrozumieć sens testu.
LLM to the rescue
Odpowiedzią na powyższe problemy jest użycie modelu LLM w niektórych krokach pętli SBST. A dokładniej, gdy algorytm wykrywa, że kolejne pętle SBST nie dają wystarczającej poprawy, do mutacji obecnej puli testów używa się AI. Model LLM lepiej znając kontekst biznesowy, robi lepszą poprawę przypadków testowych niż dotychczasowe algorytmy SBST. Do tego, AI potrafi lepiej opisać te testy, więc naturalnie stają się one znacznie czytelniejsze dla człowieka.
Dokładnie takie podejście miała grupa badaczy, opracowujących CodaMosa. Caroline Lemieux, Jeevana Priya Inala, Shuvendu K. Lahiri, Siddhartha Sen na zlecenie Microsoft, połączyli OpenAi codex oraz narzędzie Pynguin, który używa algorytm SBST o nazwie MOSA. I wyniki które osiągneli w 2023 roku okazały się oszałamiające. Hybrydowe tworzenie testów, niemalże na każdym polu okazało się zadowalające.
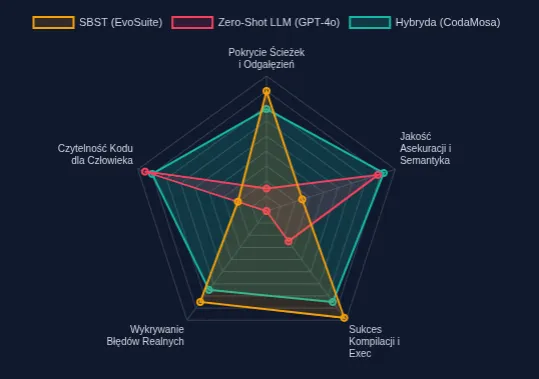
Podejście to stało się sztandarowym przykładem tzw. paradygmatu neuro-symbolicznego w inżynierii oprogramowania. Łączy ono „neuro” (semantyczną intuicję i rozumienie intencji kodu przez modele językowe) z „symbolicznym” (matematycznym, bezstronnym i algorytmicznym rygorem systemów SBST). Pozwala to ominąć największe wady obu technologii: LLM chroni SBST przed ślepotą semantyczną, a SBST chroni kod przed halucynacjami i błędami kompilacji generowanymi przez sztuczną inteligencję.
Wyniki opublikowane na konferencji ICSE w 2023 roku potwierdziły ogromną przewagę tego podejścia. Badacze przetestowali CodaMosa na 486 wymagających modułach języka Python. Hybryda osiągnęła statystycznie istotnie wyższe pokrycie kodu niż samo SBST na 173 modułach, a także wyższe niż sam model Codex na 279 modułach. Przekłada się to na średni wzrost pokrycia kodu od 9% do 10%.
Co dalej? jak to wykorzystać w naszej codziennej pracy?
Przejście od tradycyjnego testowania lub bezkrytycznego generowania testów przez AI do niezawodnego, hybrydowego przepływu pracy (ang. Neuro-Symbolic Developer Workflow) nie wymaga pisania od zera własnych narzędzi naukowych. Możemy wdrożyć te zasady w naszych zespołach za pomocą odpowiednio zaprojektowanych CI/CD oraz konfiguracji agentów AI (takich jak Cursor czy Claude Code).
Oto cztery konkretne kroki, jak przełożyć wnioski z badań empirycznych na codzienną praktykę inżynierską:
- Zastąp surowe prompty, techniką “ekstrakcji intencji”. Zrób tak, by agent przed napisaniem testów przeanalizował wpierw wymóg biznesowy. np. czytając go z github issue albo ze zgłoszenia Jiry. Niech własnymi słowami spróbuje opisać wymóg biznesowy.
- Wdróż automatyczną pętlę naprawczą ze sprzężeniem zwrotnym (Feedback Loop). Nie pozwól, aby programiści ręcznie poprawiali błędy kompilacji w testach wygenerowanych przez AI. Twój workflow deweloperski lub skrypt agenta powinien automatycznie uruchamiać kompilację lokalną, przechwytywać błędy z konsoli (stdout/stderr) i przesyłać je z powrotem do LLM z żądaniem poprawki
- Wprowadź żelazną zasadę testowania z walidacją tautologiczną („Fails Without, Passes With”), to trochę jak Test driven development. Najpierw agent na podstawie wymogu biznesowego pisze test. I sprawdza czy ten test robi fail - w przeciwnym razie pisze go ponownie (faza fails without). A później dopiero agent implementuje kod produkcyjny, aż napisany test zacznie przechodzić (faza pass with).
- Wykorzystaj AI do przełamywania płaskowyżów pokrycia w SBST. Zamiast kazać modelom LLM generować całe zestawy testów od zera (co daje niskie pokrycie w dużych projektach), zintegruj je z narzędziami SBST według tej samej metodologii co w CodaMosa. Pozwól tradycyjnemu narzędziu SBST wykonać szybką, tanią i systematyczną eksplorację kodu. Gdy narzędzie napotka barierę pokrycia, uruchom skrypt odpytujący LLM o wygenerowanie wyłącznie brakujących, poprawnych semantycznie danych wejściowych (np. poprawnie sformatowanego obiektu JSON). Wstrzyknij te dane jako semantyczne ziarna (seeds) z powrotem do algorytmu genetycznego SBST